データ生成:AI駆動型エンジニアリングの基盤
AIが予測を行う前に、データは適切に構築されなければならない。
工学分野におけるほとんどのAIモデルは、予測を行うずっと前にひっそりと失敗している。失敗の原因はアルゴリズムにあるのではなく、誰も適切に構築していないデータセットにあるのだ。.
シミュレーションを実行するたびに、設計が負荷、熱、衝撃を受けた際にどのように挙動するかという答えの一部が明らかになります。しかし、その知識は、それが作成されたプロジェクトを超えて残ることはほとんどありません。それは、散在するファイル、一貫性のないフォーマット、そして互いに連携することを想定していないソルバーの出力の中に存在しています。AIは、その知識を予測と先見性へと変換すると約束していますが、その背後にあるデータが後付けで集められたものではなく、意図的に生成されたものでなければ、それは不可能です。.
そうなると、当然ながら疑問が生じる。データ生成がこれほど重要なのであれば、実際にはどのようなことが含まれるのだろうか?
エンジニアリングデータ生成とは何か
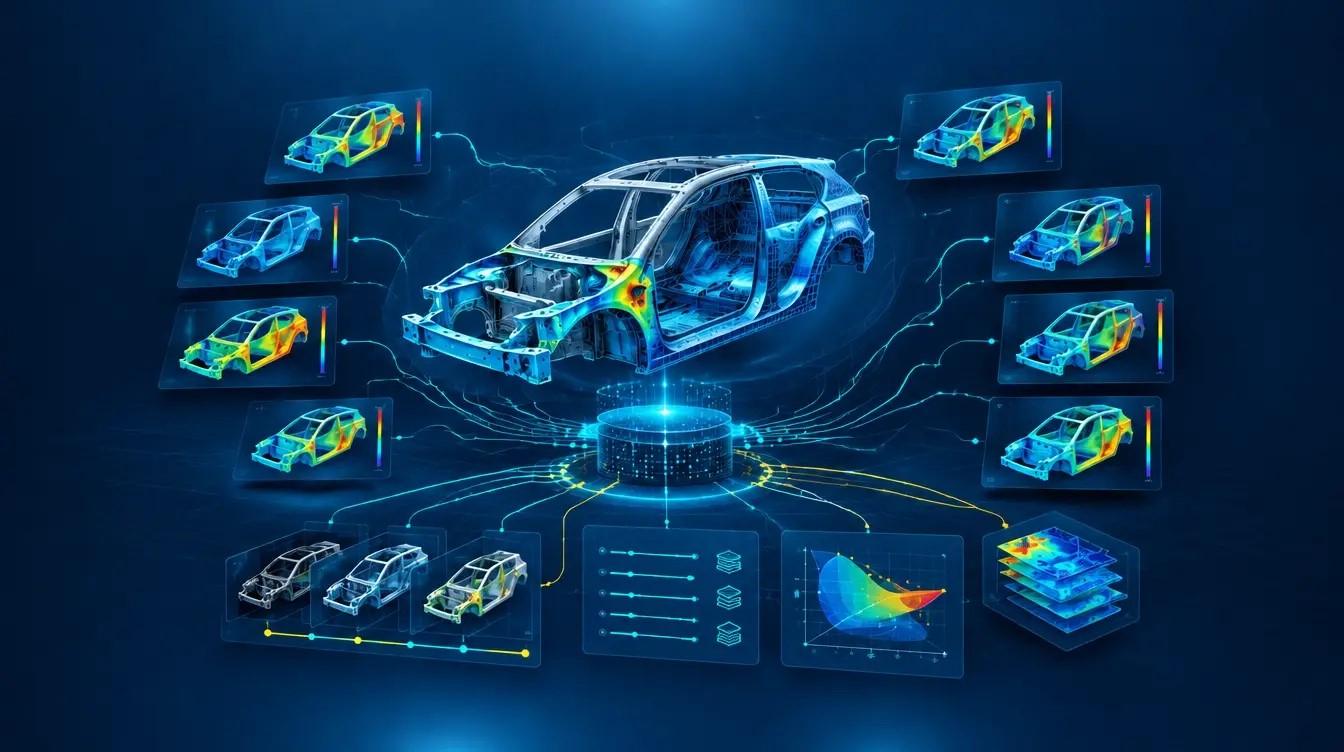
設計は白紙の状態から始めるのではなく、検証済みのモデルから始まります。エンジニアはベースラインを基に、形状、材料、厚さ、接続、荷重など、制御された変更を加えます。各バリエーションはサンプルとなり、変更された設計と、それに対する反応という2つの要素をまとめて記録します。車両ボディモデルを例にとります。パネルの厚さ、補強材の形状、溶接位置などを変更します。各バリエーションを同じ衝突条件で実行します。結果として得られるのは、設計上の選択と結果(侵入、加速度、変形、エネルギー吸収)を直接結びつけるデータセットです。手順はシンプルです。設計定義からシミュレーション設定が行われます。その設定によって物理的な反応が得られます。その反応がエンジニアリング上の知見となり、チームが実際に行動に移せるものとなります。.
これがデータ生成とデータ保存を区別する点です。シミュレーションファイルのフォルダは、過去に何が起こったかを示すだけです。適切に生成されたデータセットは、なぜそれが起こったのか、そして何かを変更した場合に何が起こるかを示します。この違いを説明するのは簡単ですが、正しく理解するには真の規律が必要です。.
エンジニアリングデータが重要な理由
1回のシミュレーションは、1つの設計、1つの条件下において、1つの疑問にしか答えることができません。それらを100回独立して実行した場合、それらを比較すること自体が新たな問題となります。.
構造化されたデータセットは、可能性を大きく広げます。個々の設計が合格か不合格かを問う代わりに、チームは設計空間全体でパフォーマンスがどのように変化するかを問うことができるようになります。これは従来とは異なる種類の問いであり、異なる種類の答えにつながります。
実際にパフォーマンスに影響を与える設計変数はどれか?
どの幾何学的領域が剛性やエネルギー吸収を促進するのか
パフォーマンスが敏感になったり、線形的な挙動を示さなくなったりする箇所
どのデザインが相反する目標を最もうまくバランスさせているか
これらはすべて、データ量だけでは解決できません。ほぼ同じモデルを100個集めても、厳選された12個にも満たないデータしか得られません。また、すべての結果には、モデルのバージョンとソルバーの設定を明確に紐づける必要があります。そうした紐づけがなければ、データセットの規模に関わらず、信頼性は低くなります。.
つまり、求められる水準は高い。意図的で、追跡可能で、多様性に富んでいる必要がある。この水準を実際の規模で満たすには、小規模なチームがスプレッドシートと手作業によるCAD編集だけでできるようなことではない。まさにこの目的のために構築されたプラットフォームが必要なのだ。.
解決策:MeshWorksとAIWorks
DEPはこのギャップを埋めるために、MeshWorksとAIWorksという2つのツールを備えたプラットフォームを構築しました。.
MeshWorksはCAEの基盤となるソフトウェアです。モデルの準備、メッシュ生成、パラメータ化、コンセプトモデリング、CADモーフィングといった基本的な機能を担い、エンジニアがすべてのモデルを手作業で再構築することなく、設計バリエーションを作成できる基盤を提供します。この基盤の重要性は、言葉で説明する以上に大きいものです。モデルを制御された再現可能な方法で変更できなければ、信頼性の高い設計群は決して実現しません。.
そこから先はAIWorksが引き継ぎます。AIWorksは得られたデータを整理し、統計分析を実行し、予測モデルを構築し、それらを設計最適化にフィードバックします。.
次のセクションでは、MeshWorksがどのようにして、ごく少数のバリエーションではなく、数百ものバリエーションを可能にするのかを見ていきます。.
データ生成の中核となる要素
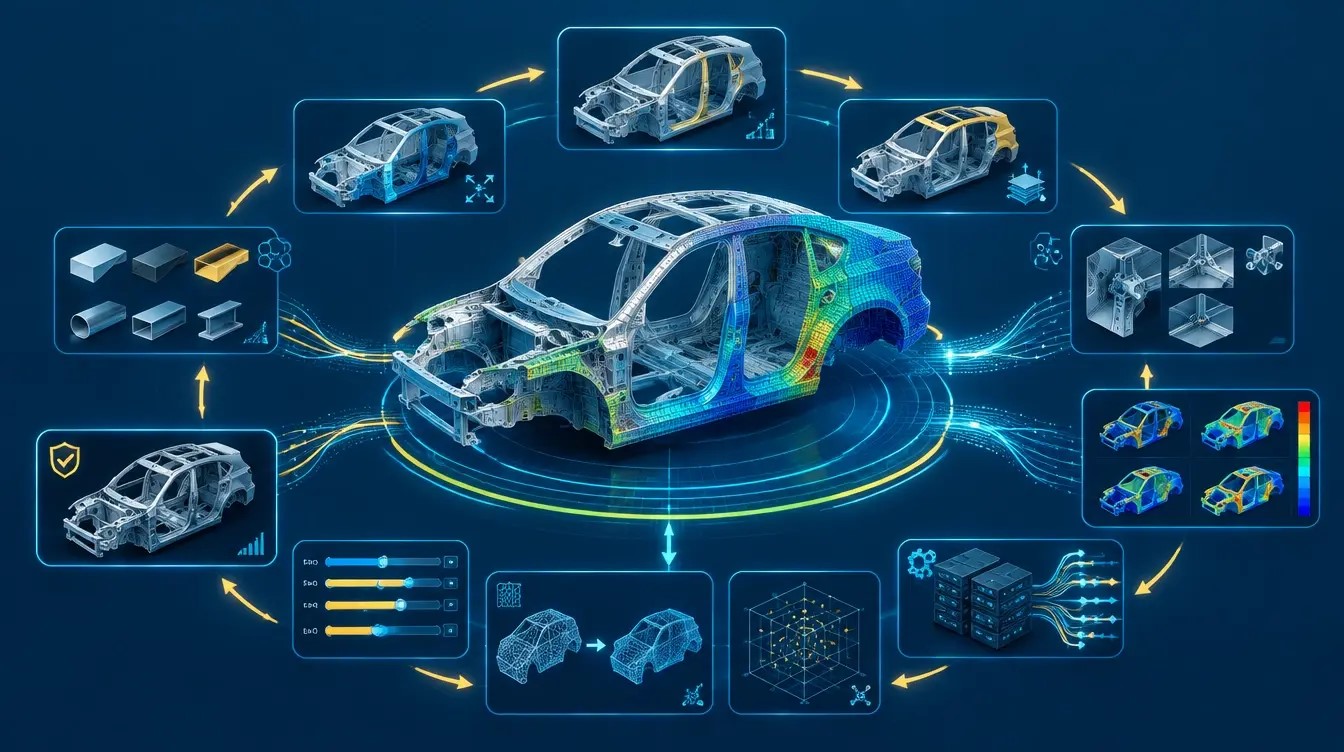
数百もの設計バリエーションを生成するには、モデルを迅速、安全、かつ再現性高く変更できることが不可欠です。MeshWorksはまさにこの点で真価を発揮します。静的なモデルを、エンジニアが単に編集するだけでなく、ジオメトリ、厚み、材質、接続部を制御された方法で変更し、手作業による再構築なしに探索できるものへと変えます。すべてのバリエーションは検証済みのベースラインと一貫性を保つため、最終的なデータセットの信頼性が確保されます。その背後にある機能は以下のとおりです。
- 検証済みのベースライン。 すべてのデータセットは、メッシュ品質が良好で、テストデータとの相関関係が既知のモデルから始まります。これを誤ると、すべてのバリアントにそのエラーが引き継がれます。
- 、設計変数を明確に定義する 。厚みの値は製造上の制約によって制限される場合があり、形状の変化は梱包スペースによって制限される場合がある。
- パラメータ化とは、 固定モデルを制御された入力に反応するモデルに変換する機能です。パラメータを調整すると、新しいバリアントが自動的に生成されます。
- メッシュモーフィング とは、既存モデルの形状を大部分維持したまま変更する手法です。詳細なCADデータを作成する前の、コンセプト開発の初期段階で特に有効です。
- 実験計画法とは、 変数範囲とそれらの相互作用に基づいて、実際にどのバリアントを構築するかを決定する手法である。
- シミュレーション自動化機能 は、各バリアントをLS-DYNA、Nastran、Abaqus、Star-CCM+などの荷重ケースに適したソルバー、または当該分野に必要な別のソルバーに送信します。また、結果がデータセットに取り込まれる前に、送信を管理し、収束性や接触挙動をチェックします。
それらのどれもが、一つのアイデアから一つのバリエーションを生み出すまでの時間を短縮する。しかし、バリエーションを生み出すことは問題の半分に過ぎない。何百ものバリエーションを、実用的な速さで解決することが、残りの半分なのだ。.
低次元モデリング(ROM)
ROMは、詳細な完全次数モデルを、重要な物理法則を損なうことなく、より高速に解ける軽量バージョンに変換します。.
その効果は実行時にすぐに現れます。非線形問題の場合、ROMは解析時間を約2日から約1日に短縮でき、2倍の改善となります。線形問題の場合、モデルを梁とスーパーエレメントの表現に変換することで、最大10倍の短縮が可能です。自動サブモデリングはこれをさらに推し進めます。通常2日かかる詳細モデルから、重要なホットスポット周辺の領域だけを分離します。このサブモデルは通常約20分で解析が完了し、エンジニアはフルモデルやCADに戻ることなく、直接このサブモデルを反復的に使用できます。.
これは、大規模な生成を現実的なものにする要素です。数種類のバリエーションであればROMなしでも簡単ですが、数百種類ものバリエーションを、しかも十分な速さで解決しなければならないとなると、そうはいきません。.
1つのモデルから数百のモデルへ
パラメータ化とROMを組み合わせると、その規模が具体的に理解できます。あるプログラムでは、単一のベースラインモデルから約200種類の構造バリエーションが生成されました。別のプログラムでは、1つのベースライン車両モデルから約250種類の側面衝突バリエーションが生成されました。これらの数字は偶然ではありません。パラメータ化によって構築する価値のあるバリエーションが生成され、ROMによってそれぞれが迅速に解決可能になるため、数百種類のバリエーションを数週間で処理でき、モデル開発に丸1年を費やす必要がなくなります。.
しかし、スピードだけではバリエーションは得られません。実際に生成する価値のある200または250のバリエーションはどれかはわかりません。それには、耐久性、振動、衝撃、電磁気学など、数十年にわたるCAEの実践経験に基づいたエンジニアリングの判断力が必要です。その判断力によって、特定の負荷ケースにおいてどのパラメータが重要か、そして結果として得られるデータセットが実際に必要な範囲をカバーしているかどうかが決まります。つまり、現時点で何百ものシミュレーションが存在するわけですが、それらの中には一体何が含まれているのでしょうか?
生成されるデータの種類
最終的な数値以上のもの。完全なデータセットは、設計とその動作との間の関係性全体を捉えます。.
- ジオメトリデータ:CADサーフェス、有限要素ノード、部品境界、フィーチャ位置
- メッシュデータ:要素品質、メッシュ密度、シェル厚さ、トポロジー
- 設計データ:材料グレード、厚さ分布、断面寸法、溶接位置
- シミュレーションデータ:荷重、拘束条件、接触条件、時間ステップ、ソルバー設定
- 出力データ:スカラー値、応答曲線、完全な空間場、応力、ひずみ、変位、圧力
- メタデータ:ソースモデル、パラメータ値、ソルバーバージョン、検証ステータス
これらをまとめて保管すれば、エンジニアリング記録となる。別々に保管すれば、単なるファイルの山となり、それらの関連性は記憶されない。そして、制御された変動によって検証済みのデータセットを作成するという根本的な原理は、分野を問わず同じである。残る課題は、これらすべてのデータを理解することだ。.
データ分析:DEPの特許取得済みボクセル化手法
これらのデータセットを意味のある比較に活用するには、エンジニアは数百もの設計組み合わせにおいて結果がどのように変化するかを理解する必要があります。しかし、既存の実験履歴では、このような全体像を把握するのに十分な比較可能なデータが得られることはほとんどありません。異なるモデルでは、メッシュ、ノード番号、ローカル座標系が異なる場合が多く、特にジオメトリがバリエーション間で変化し始めると、あるモデルのノードが別のモデルには存在しないこともあります。.
ボクセル化は、すべての設計に共通の空間言語を与えることでこの問題を解決します。3次元領域をボクセルと呼ばれる小さな体積要素に分割し、応力、厚さ、材料、変位などの形状や工学的属性をこれらの共通の位置にマッピングします。異なるモデルが1つの共通の空間表現となり、それによって集団レベルでの比較が可能になります。.
規模の拡大に伴い、この手法は不可欠となります。約2,000万ノードの詳細な衝突モデルは、それだけで約2GBの容量になります。詳細なCFD解析では、4,000万セルと20GBのファイルが必要となり、読み込むだけでも128GB近いメモリを搭載したマシンが必要になります。これらを100倍のバリエーションで比較すると、手作業での比較は現実的ではなくなります。ボクセルベースの解析は、そうでなければ埋もれてしまうような疑問に答えてくれます。どの領域がより高い性能を発揮するのか、高性能な設計と低性能な設計が実際にどこで乖離するのか、現在の設計の網羅性が低い、あるいは全く網羅されていないのはどこなのか、といった疑問です。.
DEPは、MeshWorks内に特許取得済みの統計マッピング技術としてこれを構築し、AIWorksのボクセルベースのアプローチと組み合わせました。この分野でこれに匹敵するツールはほとんどありません。これにより、シミュレーション結果のスタックを、単一のモデルをトレーニングする前に、チームが実際に信頼できるデータへと変換することができます。データが生成され、理解されると、AIモデルとして活用する準備が整います。.
データ分析:DEPの特許取得済みボクセル化手法
こうした工学的な背景を踏まえ、次の課題はAIによる予測です。エンジニアとして、信頼性が高く、かつ効率的な研究を提示する必要があります。必要な結果を得るためには、手持ちのデータが十分でなければなりません。.
簡単に言うと、訓練されたモデルの性能は、それが何を見せられたかによって決まり、また、それが検証された物理法則の信頼性によってのみ決まるということです。.
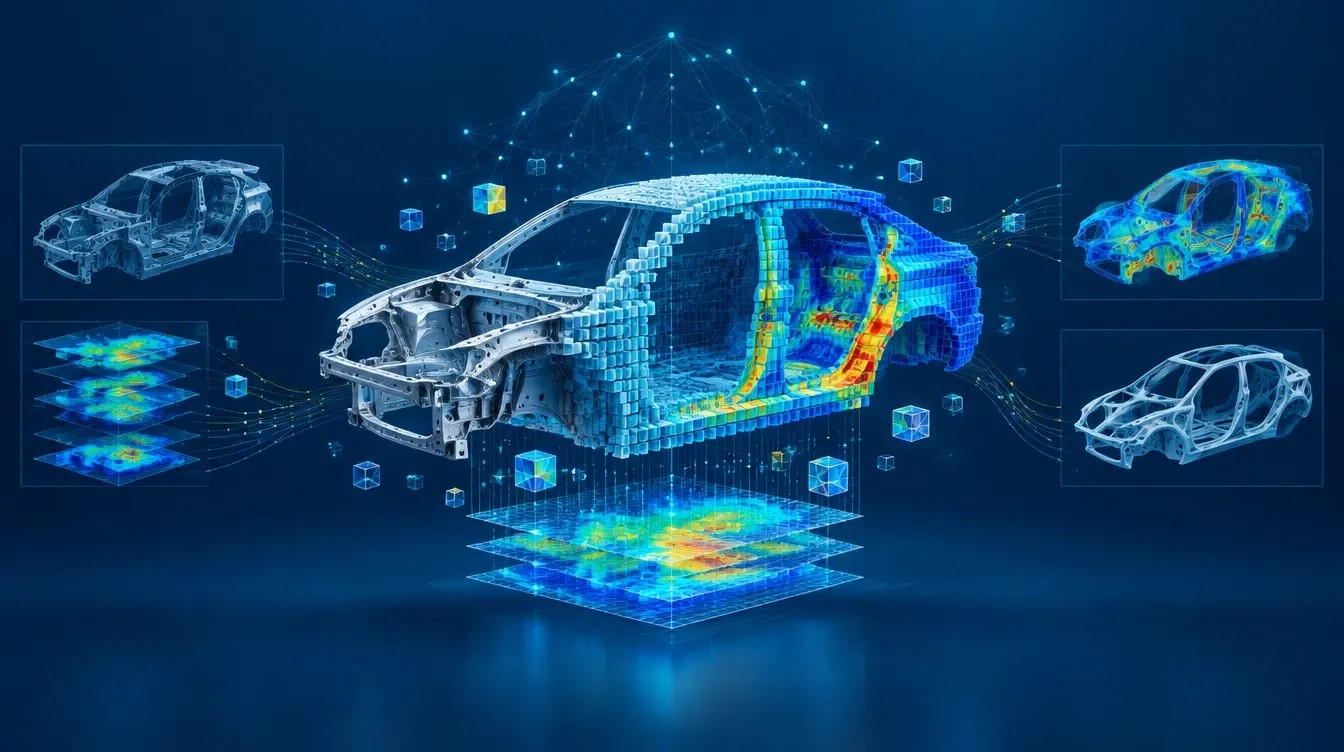
これらの基本原則が明確になったことで、エンジニアは要件に合った AI モデルを開発できるようになりました。トレーニングを開始する前に、すべてのソルバーの結果が 1 つの標準化された形式に変換されます。これにより、あるソルバーの応力結果と別のソルバーの抗力係数を直接比較できるようになり、単一のモデルがそれらすべてから一貫して学習できるようになります。トレーニングを開始する前に、すべてのソルバーの結果が 1 つの標準化された形式に変換されます。これにより、あるソルバーの応力結果と別のソルバーの抗力係数を直接比較できるようになり、単一のモデルがそれらすべてから一貫して学習できるようになります。.
トレーニング自体が二つの要素のバランスを取る必要がある。一つは、予測がシミュレーション結果とどれだけ一致するか。もう一つは、予測がその問題を支配する物理法則、つまり構造物の変形や流体の流れを記述する方程式にどれだけ忠実に従うかである。どちらか一方だけを正しくするよりも、両方を正しくする方がはるかに重要だ。過去の結果にしか一致しないモデルでも、物理的に意味をなさない形で間違っている可能性がある。物理法則の項だけを含むモデルでは、測定された現実から乖離してしまう可能性がある。.
最終的に得られるのは2種類のモデルです。予測モデルは高速ソルバーのように機能し、特定の負荷ケースに対してほぼ瞬時に解答を出力します。生成モデルは逆の働きをします。設計空間と目標値を与えると、トポロジー最適化に近い新しい形状を提案しますが、データセットから既に得られたすべての情報に基づいて設計されます。どちらの種類のモデルも、それまでに行われたすべての作業なしには実現できません。データは意図的に生成する必要があり、トレーニングを開始する前に、ボクセル化によって大規模に理解する必要がありました。.
エンジニアリングにおけるあらゆるAIモデルは、同じ静かな約束から始まります。それは、物理ベースのソルバーでは解決に何日もかかるようなことを、AIモデルは解決できるという約束です。しかし、その約束が成り立つのは、AIモデルの背後にあるデータが、AIモデルが置き換えるべきエンジニアリングと同じ厳密さで構築されている場合に限られます。これが、このすべてに共通するテーマです。意図的にデータを生成する。意味のあるレベルで迅速に解決する。信頼する前に、大規模にデータを理解する。そして、この3つすべてが満たされた場合にのみ、そのデータで学習を行う。これらのうちどれか一つでも欠けると、最終的に出来上がるモデルは、そのギャップを引き継ぐことになります。.
DEPは、機能一覧ではなく、体系的な手法として、この一連の流れに基づいてMeshWorksとAIWorksを構築しました。モデルの準備やバリアント生成から、ボクセルベースの解析、AIモデルのトレーニングまで、あらゆるステップを一つのプラットフォームで網羅しています。もはやモデル作成は難しい部分ではありません。常に難しかったのはデータであり、DEPは、そのデータを正しく、意図的に、追跡可能に、そして大規模に取得することからスタートします。.